Importez et mettez à jour vos données sans développement
Data Fair importe vos données brutes et les transforme en jeux de données standardisés, exposés automatiquement en API REST. Fichiers tabulaires et géographiques, saisie par formulaire, connecteurs vers des applications et catalogues externes, mises à jour planifiées : la plateforme industrialise la collecte et la mise à jour de votre patrimoine de données, sans développement.
Démonstration (1 min 30) : importer un fichier et le publier, importer une couche d'un catalogue et la planifier, saisir une ligne dans un jeu éditable, filtrer un jeu de données virtuel.
Tous les formats de fichiers
L'import de fichiers est le point d'entrée principal : créez un jeu de données, déposez votre fichier, la plateforme l'analyse et propose un schéma de données que vous ajustez avant de publier.
Les fichiers sont chargés tels quels ou compressés (GZIP, ZIP). Un même jeu de données se met ensuite à jour en redéposant un fichier, en le poussant par API ou depuis un connecteur.
| Famille | Formats |
|---|---|
| Tabulaires | .csv, .tsv, .txt, .dif, .dbf, .xls, .xlsx, .ods, .fods |
| JSON | .json, .ndjson |
| Géographiques | .geojson, .kml, .kmz, .gpx, .gpkg |
| Archives ZIP | Shapefile (.shp, .shx, .dbf, .prj), MapInfo |
| Autres | .ics, .xml |
Saisie par formulaire et modifications en masse
Le schéma d'un jeu de données peut être saisi directement ou repris d'un schéma de référence de schema.data.gouv.fr. Un formulaire de saisie est alors généré automatiquement pour créer, mettre à jour et supprimer des lignes.
Les modifications en masse se font par chargement de fichier, avec le choix d'ajouter ou de remplacer les lignes existantes. Une mise à jour partielle est possible dès qu'une clé primaire est définie sur une ou plusieurs colonnes.
Connecteurs et planification
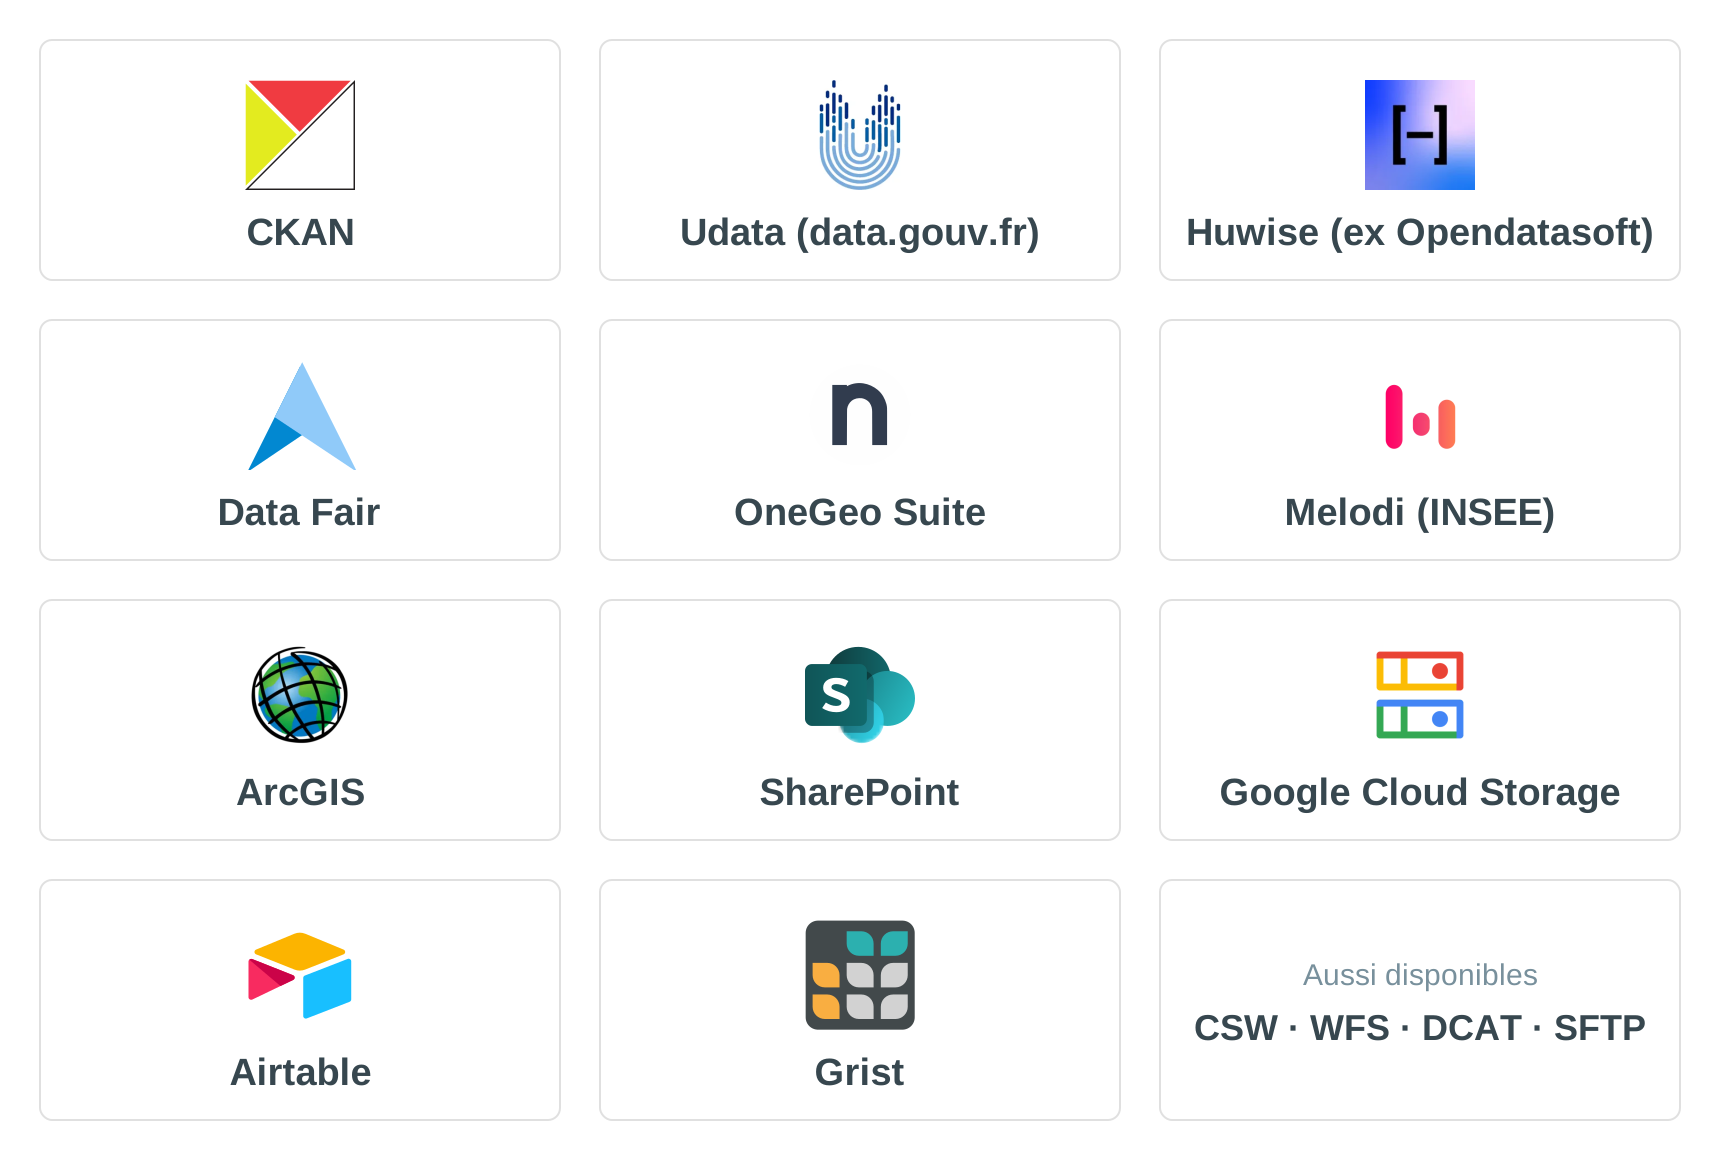
Les connecteurs vont chercher les données à la source, les transforment et les importent automatiquement. Chaque connecteur a son propre paramétrage (source, authentification, périmètre) et partage les mêmes options de planification.
Chaque connecteur est détaillé dans Connecteurs de catalogues et de données, qui présente aussi CSW, WFS, DCAT et SFTP ; la planification et le suivi des exécutions se pilotent depuis Traitements et imports planifiés.
Historique, alertes et reprises
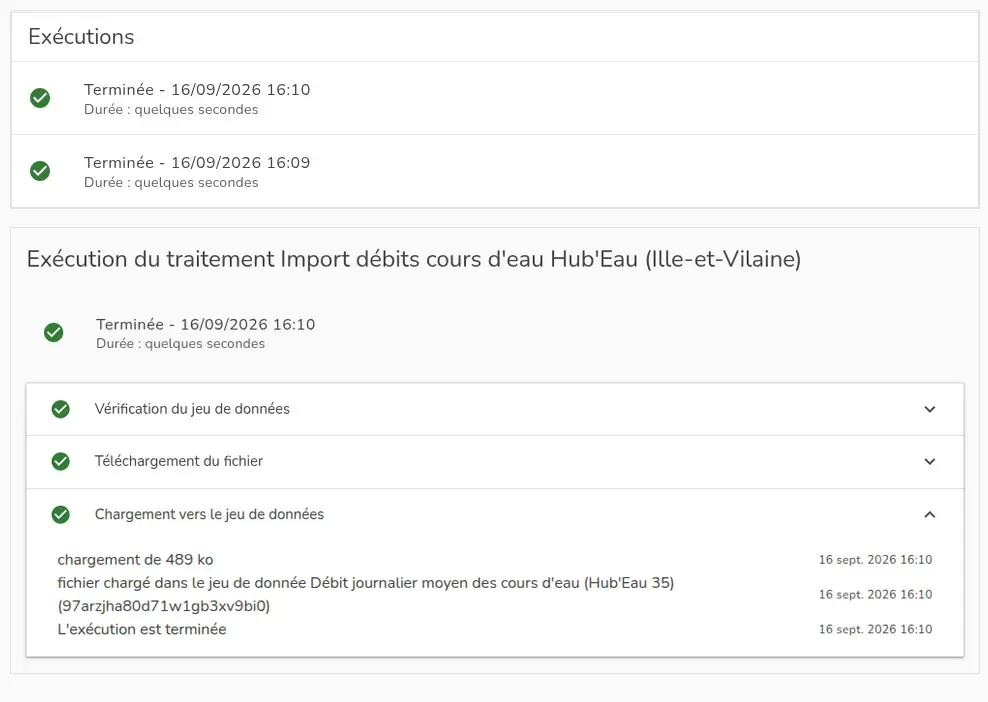
Chaque exécution est tracée : statut (succès, échec partiel, échec total), date et heure, durée, volumétrie traitée et journal détaillé des étapes pour investiguer.
En cas d'échec, des notifications par e-mail ou webhook alertent les administrateurs, et des politiques de répétition automatique tentent de récupérer les erreurs temporaires. Un traitement qui échoue dix fois de suite est automatiquement désactivé ; ses règles de planification sont conservées, il suffit de corriger la cause pour le réactiver.
Jeux de données virtuels
Un jeu de données virtuel est une vue calculée d'un ou plusieurs jeux de données, sans duplication :
- créer une vue publique restreinte à certaines lignes et colonnes d'un jeu de données qui reste privé ;
- anonymiser des données ;
- limiter un jeu de données national à un ou plusieurs territoires, à partir des codes INSEE de région, de département, d'EPCI ou de commune ;
- regrouper des données millésimées ou territorialisées publiées dans un format constant ;
- concaténer plusieurs jeux de données partageant des colonnes communes.
Mise à jour via l'API
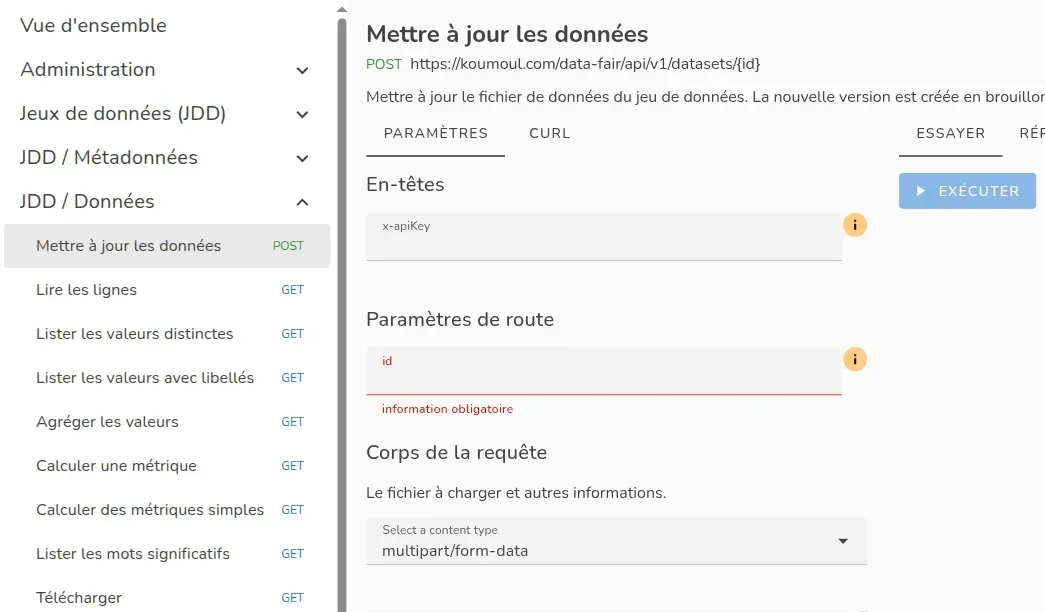
Toutes les opérations de l'interface sont aussi réalisables par API : importer un fichier, modifier une ligne, renseigner les métadonnées, lancer un enrichissement. Un système d'information interne peut ainsi envoyer ses fichiers chaque nuit sans être exposé publiquement, avec une clé d'API aux droits limités.
La documentation est intégrée à la plateforme : chaque opération y est décrite, testable directement dans la page.